Perguntas
Perguntas frequentes sobre OneVeer.
Respostas curtas às perguntas que os avaliadores fazem primeiro. As mesmas respostas são publicadas nos dados estruturados da página.
O que é um gateway LLM?
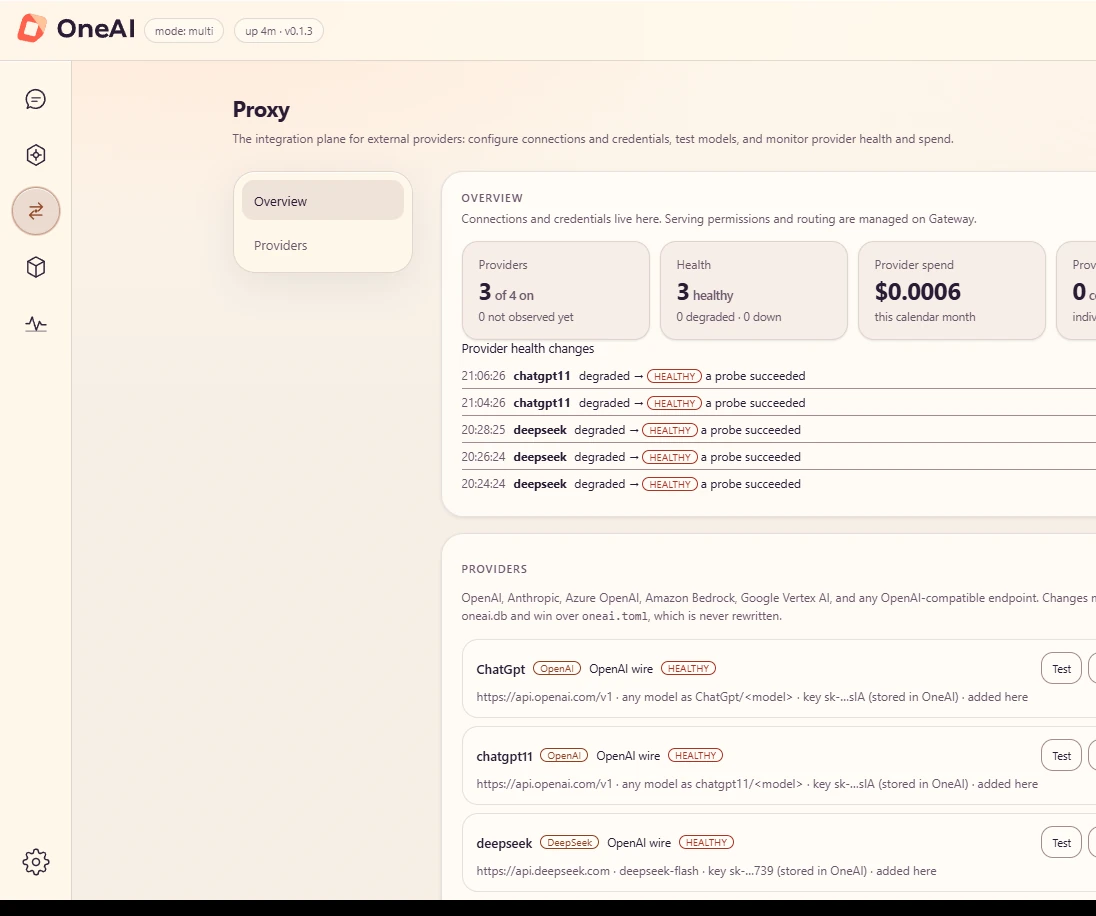
Um gateway LLM (também chamado de gateway AI ou gateway de inferência) é um servidor entre aplicativos e modelos. Os aplicativos chamam um endpoint; o gateway os autentica, escolhe o modelo ou provedor, aplica a política e registra o que aconteceu. OneVeer é um gateway LLM que também executa os próprios modelos, em seu próprio hardware, no mesmo processo.
OneVeer é uma alternativa para vLLM?
Para um trabalho diferente. vLLM é um sistema de serviço Python desenvolvido para produtividade de data center em clusters de GPU. OneVeer tem como alvo um único nó que você controla: um servidor nativo que combina um mecanismo de inferência llama.cpp (CPU, Vulkan, CUDA) com um gateway, um mecanismo de política e roteamento de provedor. Escolha vLLM para serviço em escala de cluster; escolha OneVeer quando o requisito for um gateway governado executado onde seus dados residem.
OneVeer é uma alternativa ao Ollama?
Ollama é um model runner local voltado para desenvolvedores individuais. OneVeer foi desenvolvido para colocar modelos locais na frente de aplicativos e equipes: chaves de aplicativos com concessões e limites de modelo, um catálogo de modelos publicado, roteamento para provedores de nuvem com fallback e orçamentos, proteção de modelos contra injeção imediata, redação de PII, parada de emergência, métricas Prometheus e exportação OpenTelemetry. Ambos usam a pilha llama.cpp/ggml para inferência local.
OneVeer funciona com os SDKs OpenAI e Anthropic?
Sim. OneVeer atende pontos de extremidade de bate-papo, conclusões, incorporações e modelos compatíveis com OpenAI e o ponto de extremidade de mensagens Anthropic. Aponte o URL base do SDK para OneVeer e mantenha o código do cliente. Claude Code, Cursor, Codex CLI, LangChain, n8n, LibreChat e qualquer ferramenta compatível com OpenAI funcionam da mesma maneira.
Em qual hardware OneVeer é executado?
CPU, GPUs NVIDIA, AMD e Intel até Vulkan (a compilação padrão) e GPUs NVIDIA até CUDA. O Windows 11 é a plataforma validada; As compilações do Linux e do macOS ainda não são certificadas. OneVeer dimensiona cada modelo em relação à memória livre e o coloca em uma GPU, entre GPUs, como um híbrido MoE com especialistas em RAM ou na CPU.
Os dados saem da minha máquina?
Somente através de uma rota de provedor que você configurou. Os modelos locais são executados dentro do processo OneVeer. Um switch mestre ou um cabeçalho por solicitação fixa solicitações em modelos locais. A exportação do OpenTelemetry está desativada por padrão e nunca inclui prompts, conclusões, cargas de ferramentas ou chaves.
Como OneVeer lida com injeção imediata e dados pessoais?
Os modelos de guarda (Prompt Guard 2, ProtectAI DeBERTa v3, Llama Guard 3 e Granite Guardian HAP) inspecionam entrada, contexto recuperado e saída; uma falha do detector falha no fechamento por padrão. Um detector Rust local encontra endereços de e-mail, números de telefone, cartões de pagamento, IBANs, SSNs dos EUA e endereços IP e pode observar, substituir, mascarar, pseudonimizar ou negar.
Quais formatos de modelo são suportados por OneVeer?
GGUF arquivos para modelos de chat e codificadores da família BERT (incorporação, classificação, reclassificação), além de modelos Whisper, Piper e Kokoro empacotados para fala. Os modelos podem ser retirados do Hugging Face ou colocados na pasta de modelos.
OneVeer é de código aberto?
Não. OneVeer é software proprietário de Onega, disponível sob licença comercial; o proprietário da licença é Onega. Ele se baseia em llama.cpp, que é licenciado pelo MIT. Solicite um passo a passo para avaliá-lo.