Questions
Foire aux questions sur OneVeer.
Des réponses courtes aux questions posées en premier par les évaluateurs. Les mêmes réponses sont publiées dans les données structurées de la page.
Qu'est-ce qu'une passerelle LLM ?
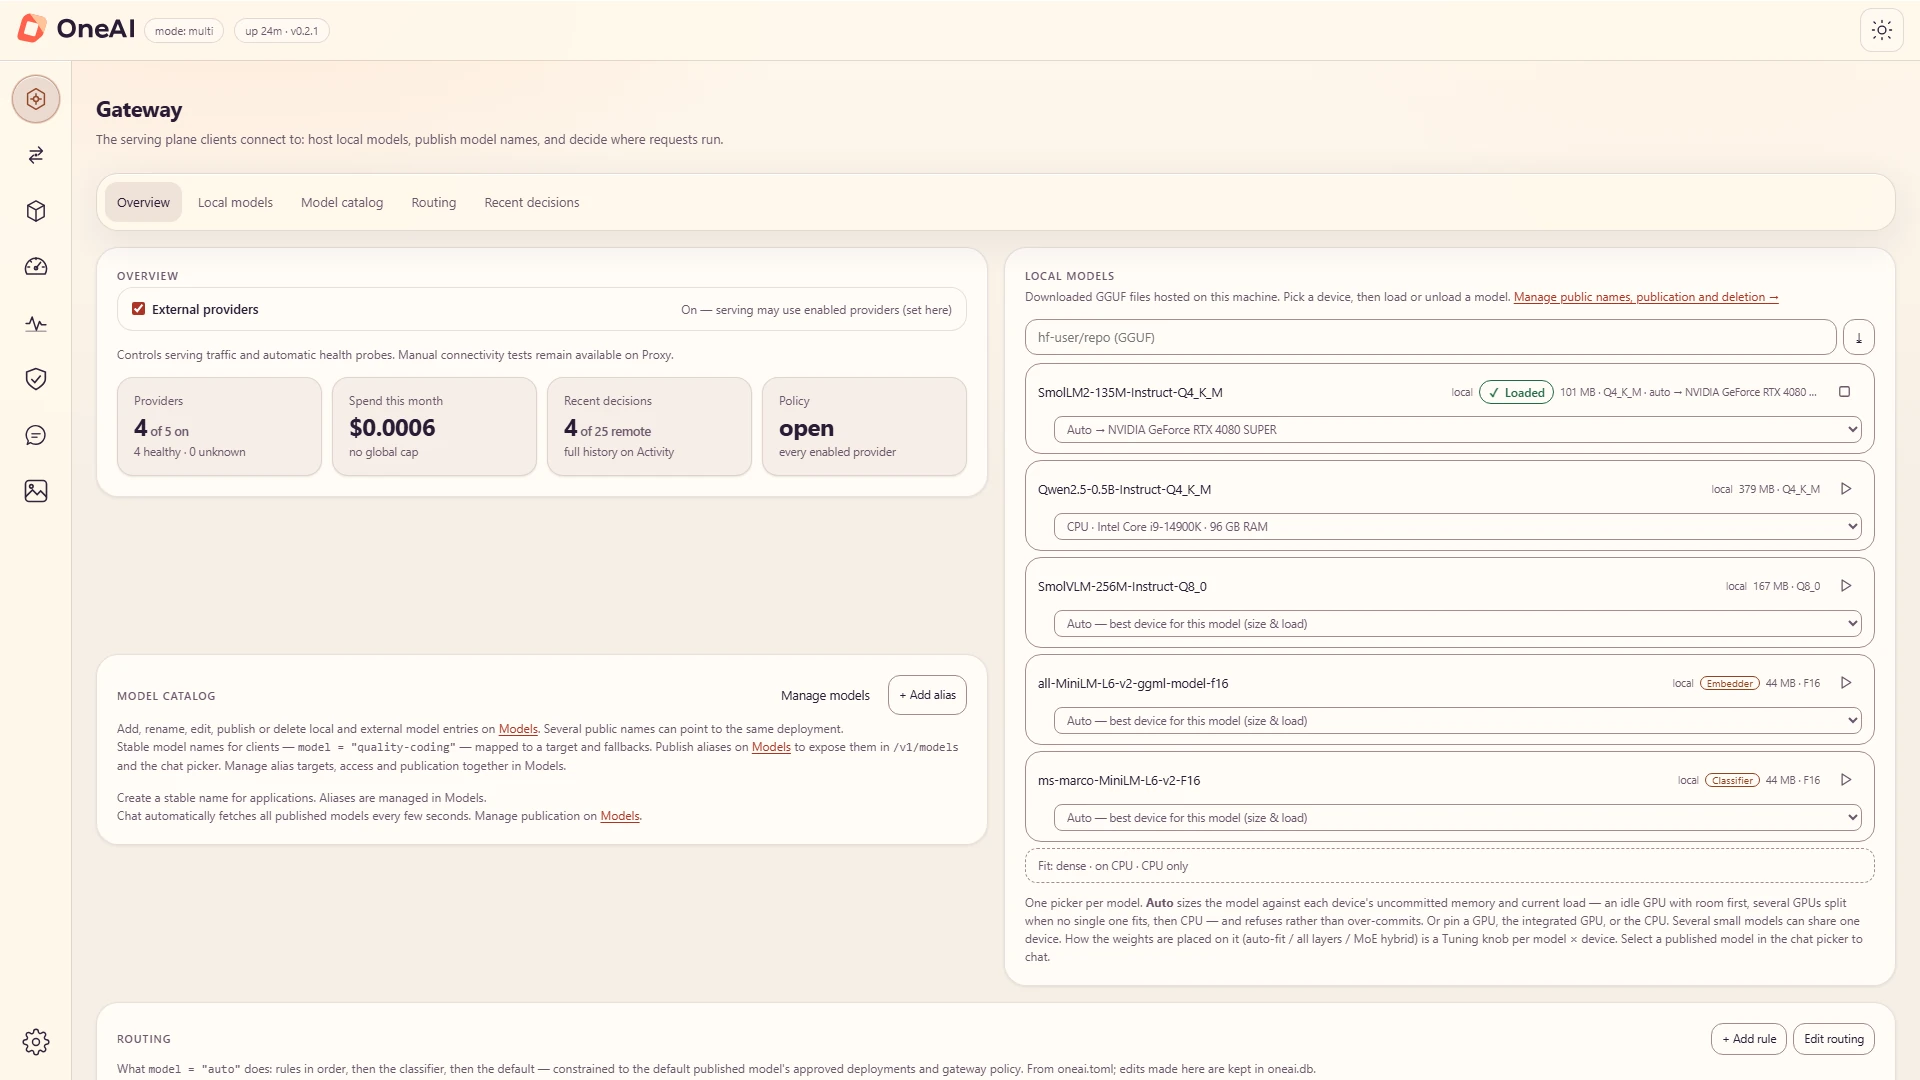
Une passerelle LLM (également appelée passerelle AI ou passerelle d'inférence) est un serveur entre les applications et les modèles. Les applications appellent un point de terminaison ; la passerelle les authentifie, choisit le modèle ou le fournisseur, applique la politique et enregistre ce qui s'est passé. OneVeer est une passerelle LLM qui exécute également les modèles elle-même, sur votre propre matériel, dans le même processus.
OneVeer est-il une alternative à vLLM ?
Pour un autre travail. vLLM est un système de service Python conçu pour le débit des centres de données sur les clusters GPU. OneVeer cible un seul nœud que vous contrôlez : un serveur natif qui combine un moteur d'inférence llama.cpp (CPU, Vulkan, CUDA) avec une passerelle, un moteur de politique et un routage de fournisseur. Choisissez vLLM pour une diffusion à l'échelle du cluster ; choisissez OneVeer lorsque l'exigence est une passerelle gouvernée qui s'exécute là où résident vos données.
Le OneVeer est-il une alternative à Ollama ?
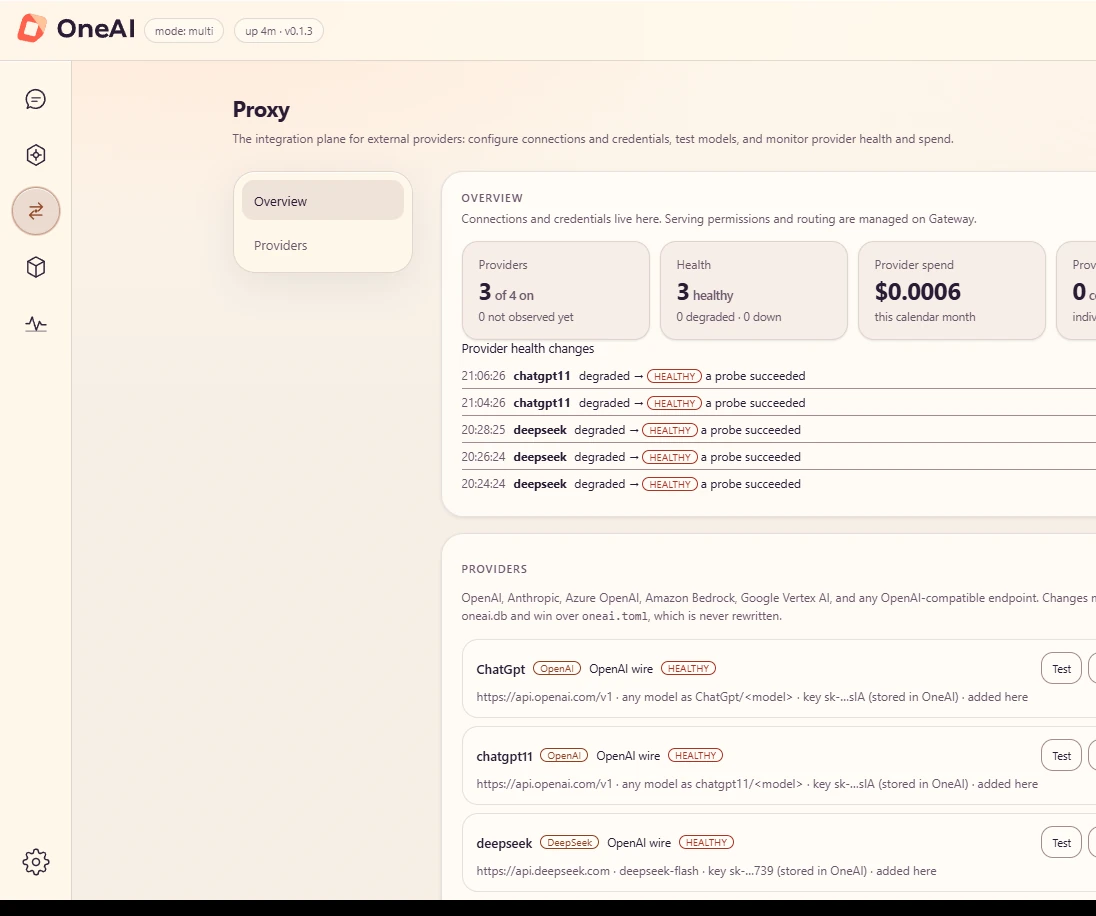
Ollama est un coureur de modèles local destiné aux développeurs individuels. OneVeer est conçu pour présenter les modèles locaux aux applications et aux équipes : clés d'application avec autorisations et limites de modèle, catalogue de modèles publié, routage vers des fournisseurs de cloud avec repli et budgets, protection des modèles contre une injection rapide, rédaction de PII, arrêt d'urgence, métriques Prometheus et exportation OpenTelemetry. Les deux utilisent la pile llama.cpp/ggml pour l'inférence locale.
Est-ce que OneVeer fonctionne avec les SDK OpenAI et Anthropic ?
Oui. OneVeer sert les points de terminaison de chat, de complétions, d'intégrations et de modèles compatibles OpenAI ainsi que le point de terminaison de messages Anthropic. Pointez l'URL de base du SDK sur OneVeer et conservez le code client. Claude Code, Cursor, Codex CLI, LangChain, n8n, LibreChat et tout outil compatible OpenAI fonctionnent de la même manière.
Sur quel matériel OneVeer fonctionne-t-il ?
CPU, GPU NVIDIA, AMD et Intel jusqu'à Vulkan (la version par défaut) et GPU NVIDIA jusqu'à CUDA. Windows 11 est la plateforme validée ; Les versions Linux et macOS ne sont pas encore certifiées. OneVeer dimensionne chaque modèle en fonction de la mémoire libre et le place sur un GPU, sur plusieurs GPU, en tant qu'hybride MoE avec des experts en RAM, ou sur le CPU.
Les données quittent-elles ma machine ?
Uniquement via une route de fournisseur que vous avez configurée. Les modèles locaux s'exécutent dans le processus OneVeer. Un commutateur principal ou un en-tête par requête épingle les requêtes aux modèles locaux. L'exportation OpenTelemetry est désactivée par défaut et n'inclut jamais les invites, les complétions, les charges utiles d'outils ou les clés.
Comment OneVeer gère-t-il l'injection rapide et les données personnelles ?
Les modèles Guard (Prompt Guard 2, ProtectAI DeBERTa v3, Llama Guard 3 et Granite Guardian HAP) inspectent les entrées, le contexte récupéré et la sortie ; une panne de détecteur échoue fermée par défaut. Un détecteur local Rust trouve les adresses e-mail, les numéros de téléphone, les cartes de paiement, les IBAN, les SSN américains et les adresses IP et peut observer, remplacer, masquer, pseudonymiser ou refuser.
Quels formats de modèles sont pris en charge par OneVeer ?
GGUF fichiers pour les modèles de discussion et les encodeurs de la famille BERT (intégrations, classification, reclassement), ainsi que les modèles packagés Whisper, Piper et Kokoro pour la parole. Les modèles peuvent être extraits de Hugging Face ou déposés dans le dossier des modèles.
OneVeer est-il open source ?
Non. OneVeer est un logiciel propriétaire de Onega, disponible sous licence commerciale ; le propriétaire de la licence est Onega. Il s'appuie sur llama.cpp, qui est sous licence MIT. Demandez une procédure pas à pas pour l’évaluer.