Domande
Domande frequenti su OneVeer.
Risposte brevi alle domande poste dai valutatori per prime. Le stesse risposte sono pubblicate nei dati strutturati della pagina.
Cos'è un gateway LLM?
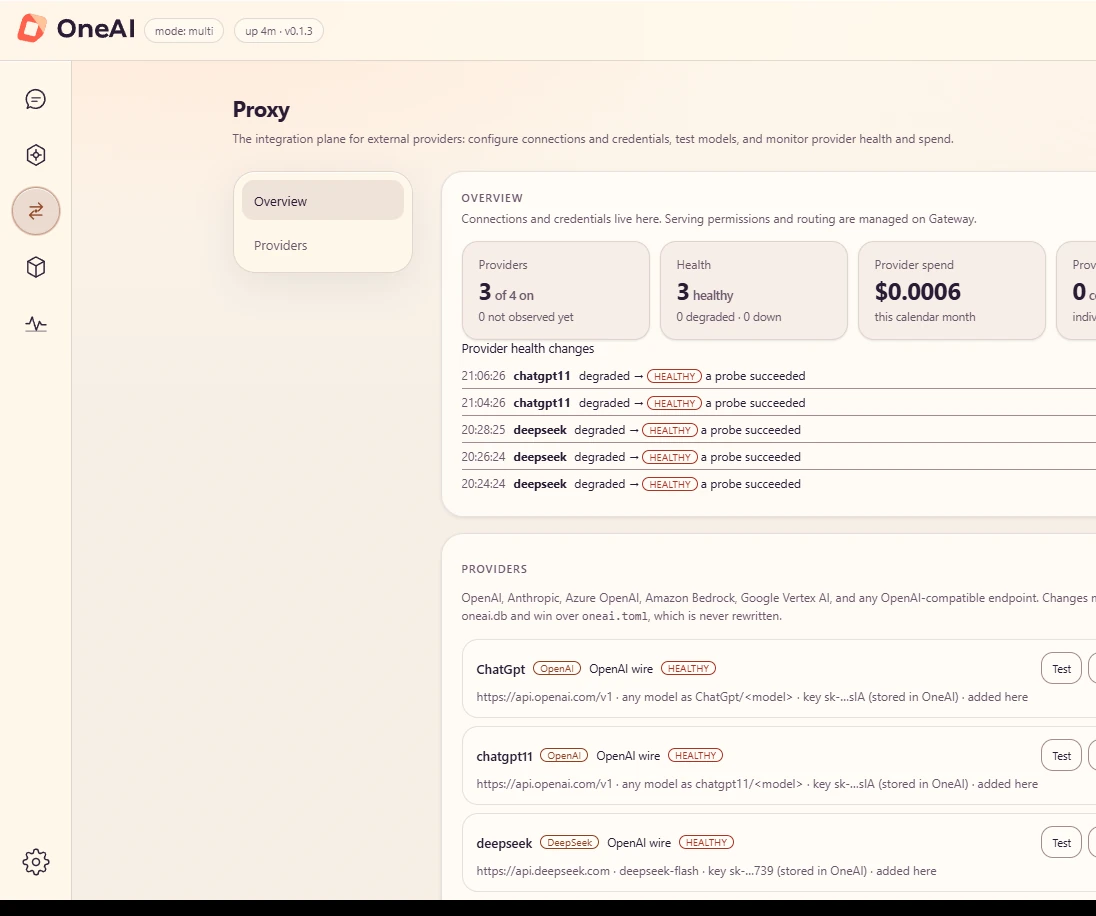
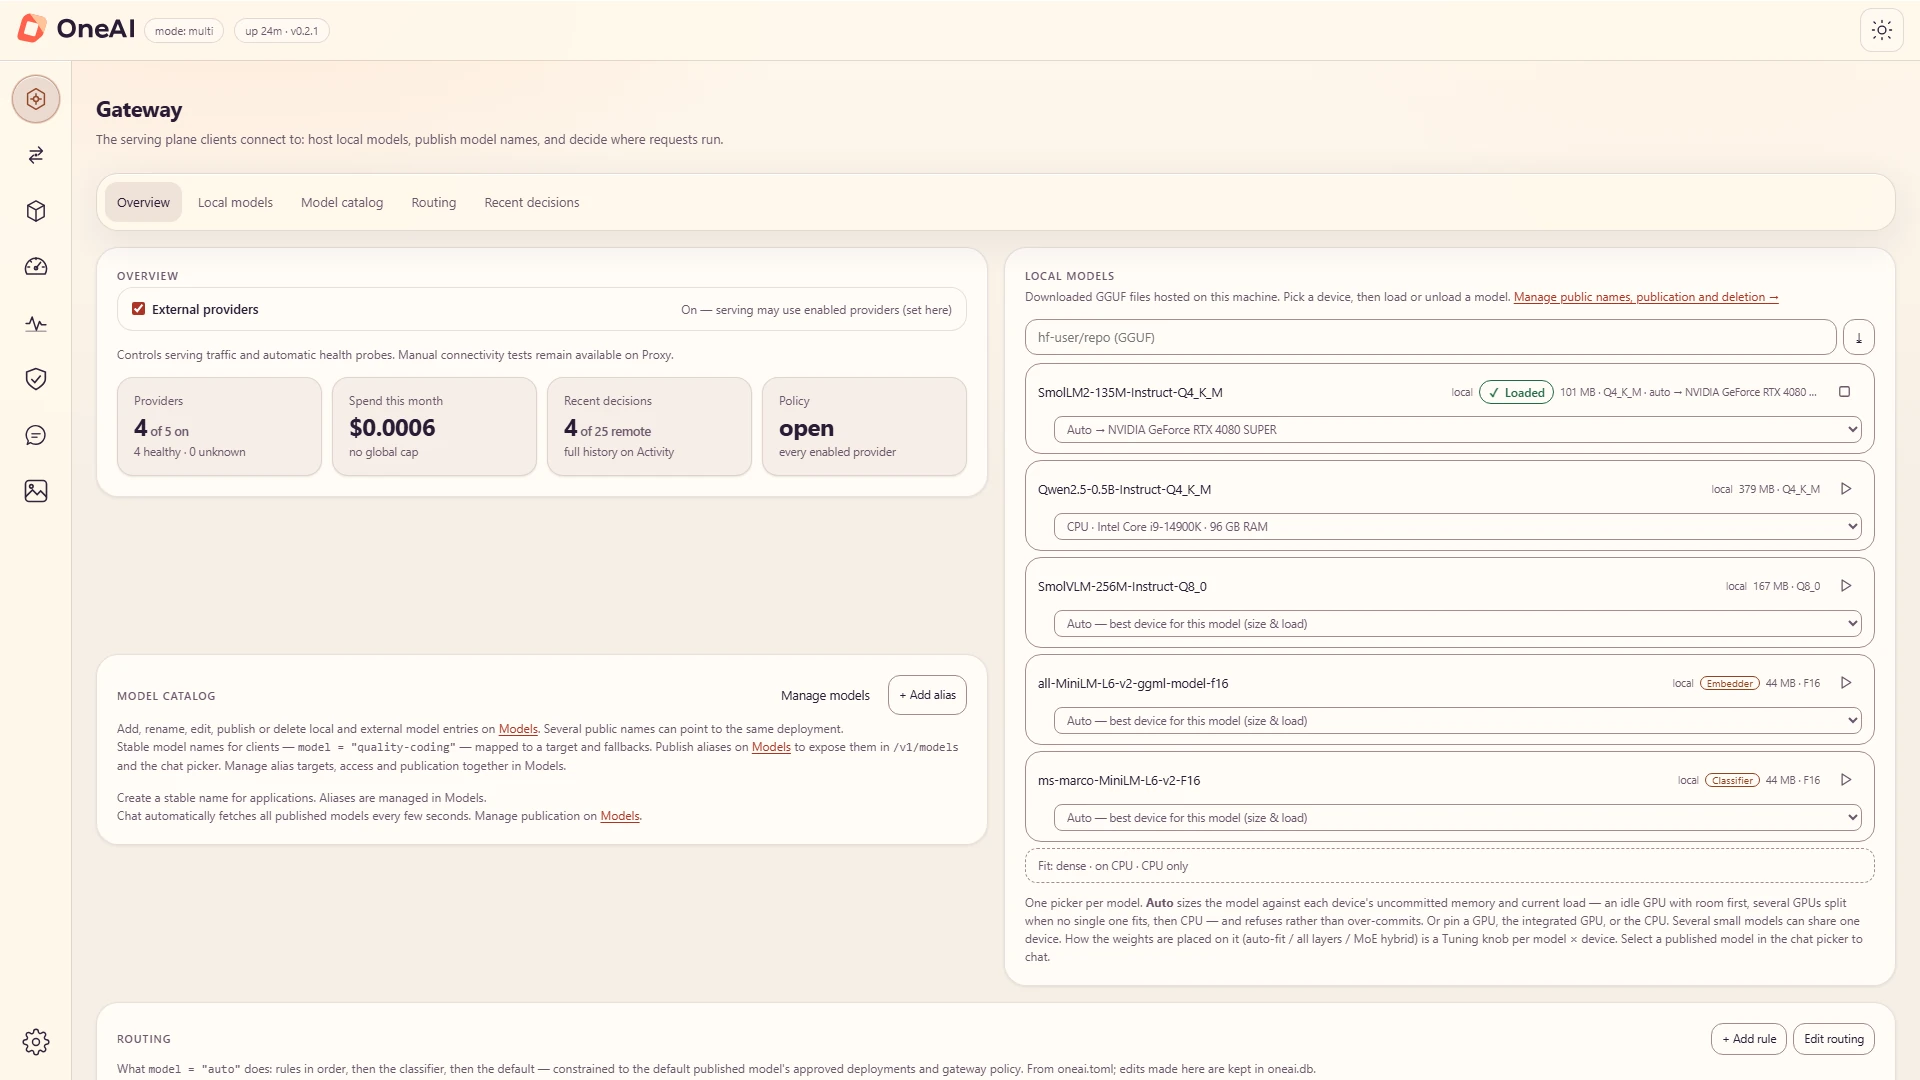
Un gateway LLM (chiamato anche gateway AI o gateway di inferenza) è un server tra applicazioni e modelli. Le applicazioni chiamano un endpoint; il gateway li autentica, sceglie il modello o il provider, applica la policy e registra l'accaduto. OneVeer è un gateway LLM che esegue anche i modelli stessi, sul tuo hardware, nello stesso processo.
OneVeer è un'alternativa a vLLM?
Per un lavoro diverso. vLLM è un sistema di servizio Python creato per il throughput dei data center su cluster GPU. OneVeer ha come target un singolo nodo che controlli: un server nativo che combina un motore di inferenza llama.cpp (CPU, Vulkan, CUDA) con un gateway, un motore di policy e il routing del provider. Scegli vLLM per il servizio su scala cluster; scegli OneVeer quando il requisito è un gateway governato che venga eseguito dove risiedono i tuoi dati.
OneVeer è un'alternativa a Ollama?
Ollama è un runner modello locale rivolto a singoli sviluppatori. OneVeer è progettato per mettere modelli locali di fronte ad applicazioni e team: chiavi dell'applicazione con concessioni e limiti del modello, un catalogo di modelli pubblicato, instradamento a fornitori di servizi cloud con fallback e budget, modelli di protezione dall'inserimento tempestivo, redazione PII, arresto di emergenza, metriche Prometheus ed esportazione OpenTelemetry. Entrambi utilizzano lo stack llama.cpp/ggml per l'inferenza locale.
OneVeer funziona con gli SDK OpenAI e Anthropic?
SÌ. OneVeer serve chat, completamenti, incorporamenti ed endpoint di modelli compatibili con OpenAI e l'endpoint dei messaggi Anthropic. Punta l'URL di base dell'SDK su OneVeer e conserva il codice client. Claude Code, Cursor, Codex CLI, LangChain, n8n, LibreChat e qualsiasi strumento compatibile con OpenAI funzionano allo stesso modo.
Su quale hardware funziona OneVeer?
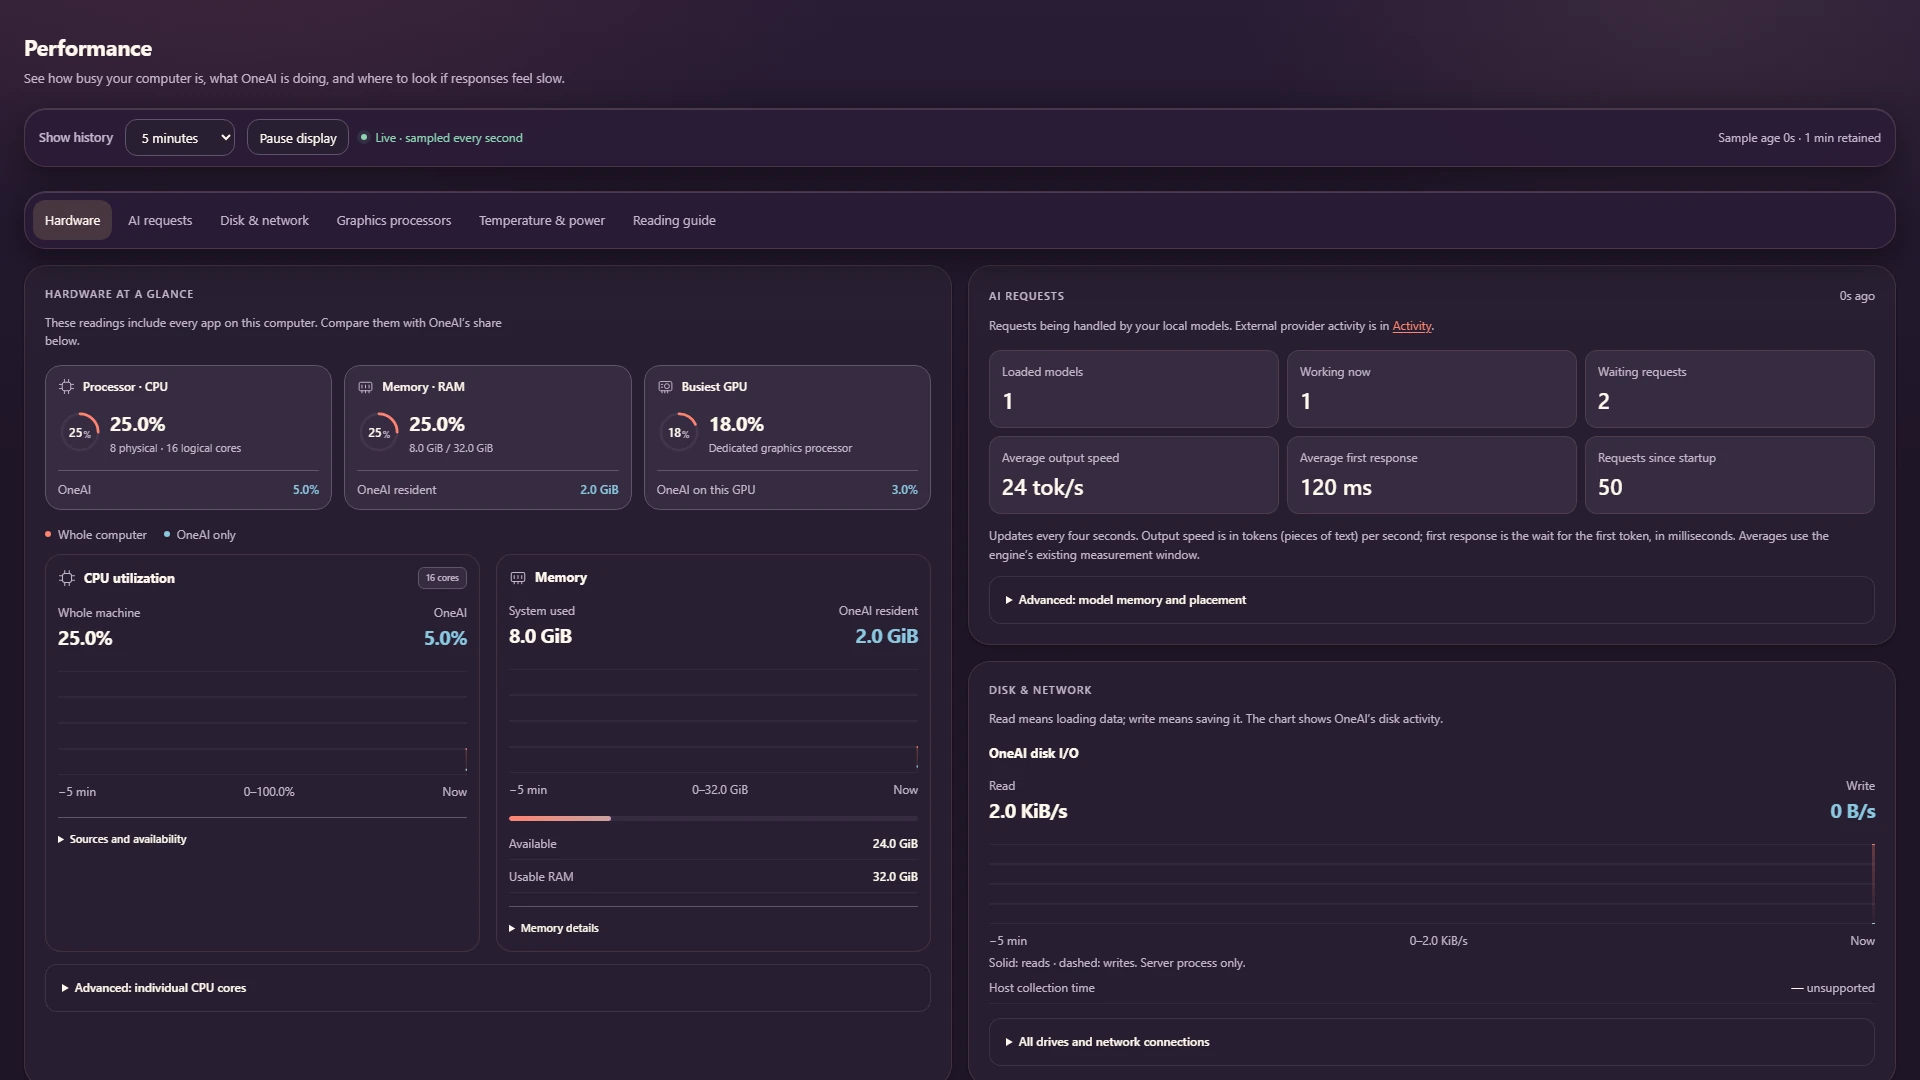
CPU, GPU NVIDIA, AMD e Intel tramite Vulkan (la build predefinita) e GPU NVIDIA tramite CUDA. Windows 11 è la piattaforma convalidata; Le build Linux e macOS non sono ancora certificate. OneVeer dimensiona ciascun modello in base alla memoria libera e lo posiziona su una GPU, tra GPU, come ibrido MoE con esperti in RAM o sulla CPU.
I dati lasciano la mia macchina?
Solo attraverso un percorso del provider configurato da te. I modelli locali vengono eseguiti all'interno del processo OneVeer. Uno switch principale o un'intestazione per richiesta collega le richieste ai modelli locali. L'esportazione di OpenTelemetry è disattivata per impostazione predefinita e non include mai richieste, completamenti, payload di strumenti o chiavi.
In che modo OneVeer gestisce l'inserimento immediato e i dati personali?
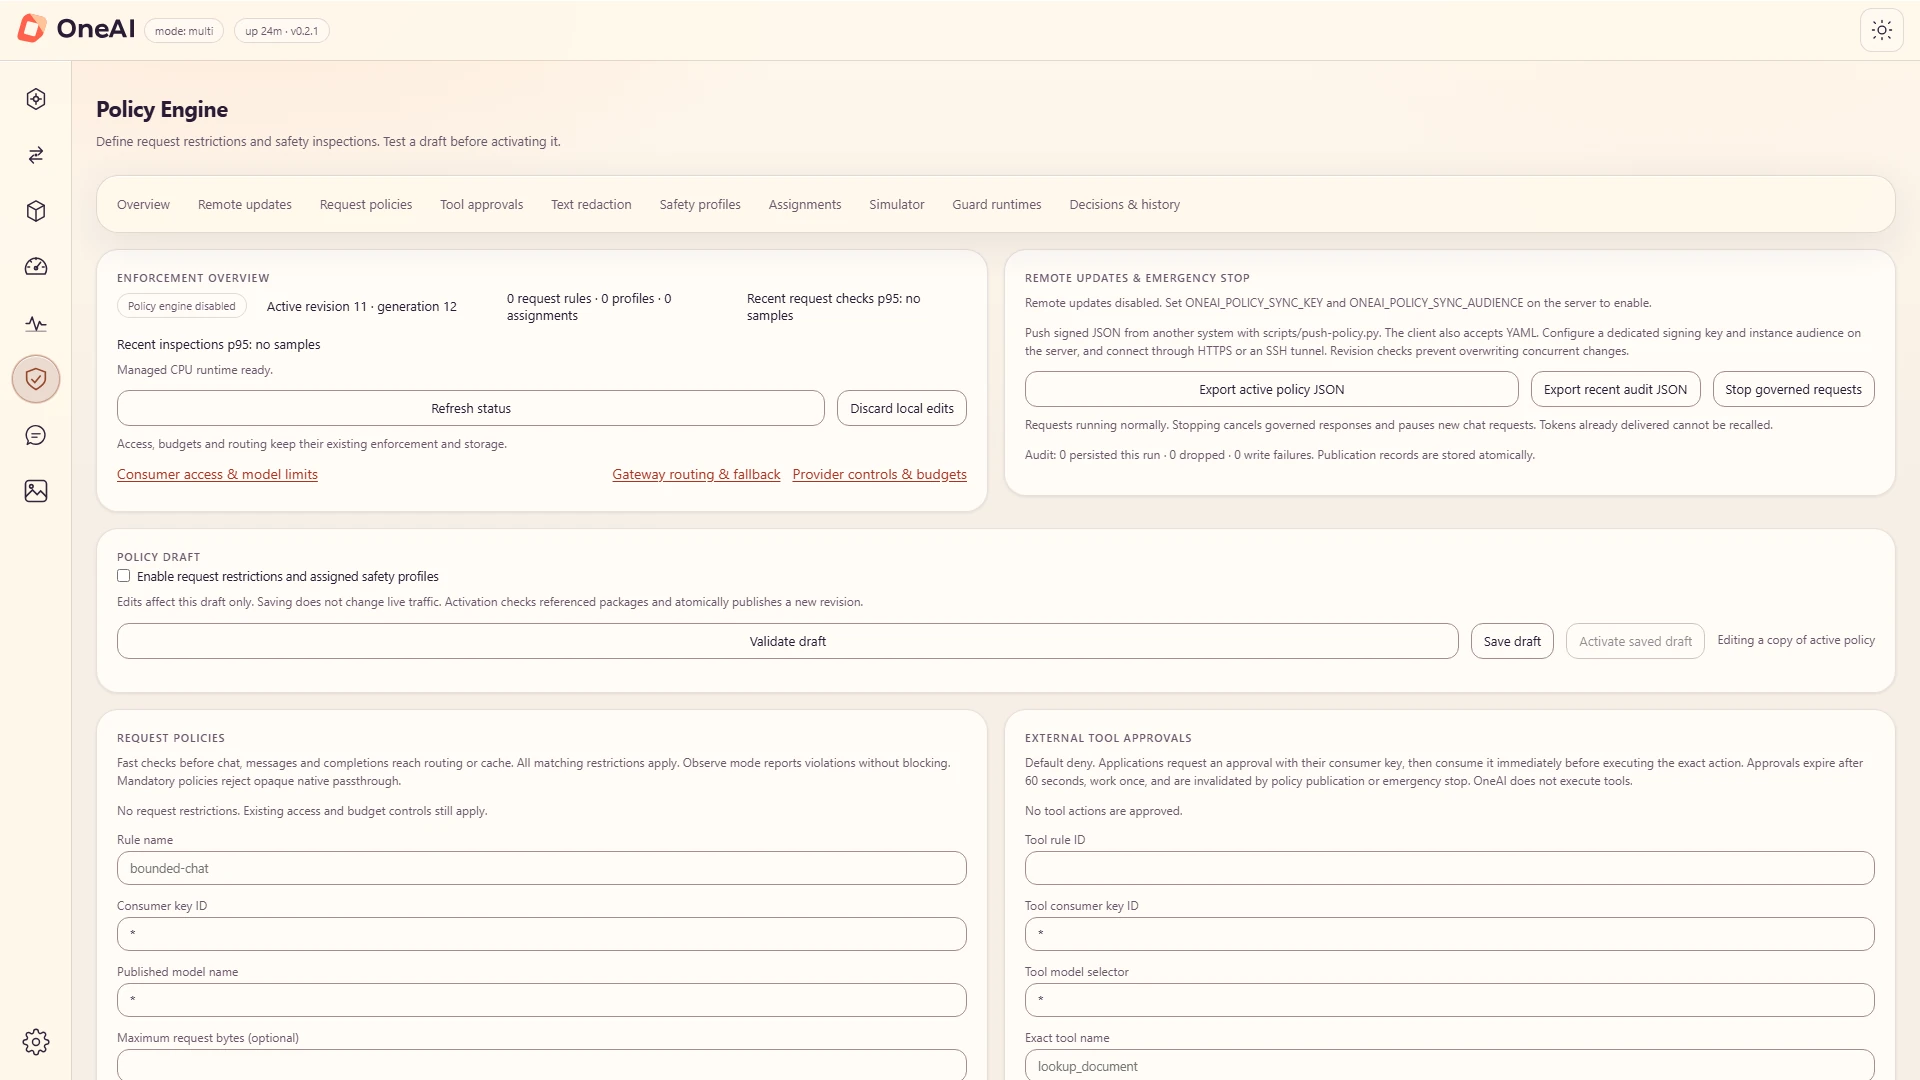
I modelli Guard (Prompt Guard 2, ProtectAI DeBERTa v3, Llama Guard 3 e Granite Guardian HAP) ispezionano input, contesto recuperato e output; un guasto del rilevatore non viene chiuso per impostazione predefinita. Un rilevatore Rust locale trova indirizzi e-mail, numeri di telefono, carte di pagamento, IBAN, SSN statunitensi e indirizzi IP e può osservare, sostituire, mascherare, pseudonimizzare o negare.
Quali formati di modello supporta OneVeer?
File GGUF per modelli di chat e codificatori della famiglia BERT (incorporamenti, classificazione, riclassificazione), oltre a modelli Whisper, Piper e Kokoro pacchettizzati per il parlato. I modelli possono essere estratti da Hugging Face o inseriti nella cartella dei modelli.
OneVeer è open source?
No. OneVeer è un software proprietario di Onega, disponibile con licenza commerciale; il proprietario della licenza è Onega. Si basa su llama.cpp, che ha la licenza MIT. Richiedi una procedura dettagliata per valutarlo.